SearcherVision

Googlebot · GPTBot · ClaudeBot · PerplexityBot

Mira tu página como la ven Google y la IA

Análisis SEO de renderizado, indexación, W3C, datos estructurados y velocidad: cada problema, marcado sobre la propia página en un corte 3D de su DOM.

Qué analizar

Gratis durante la beta, sin registro

Pro está en camino: acceso anticipado

olive-tattoo.ruun análisis real

Así se ve

La grabación de un análisis real de un sitio en producción, acelerada.Grabado con la interfaz en ruso; la app también está en español.

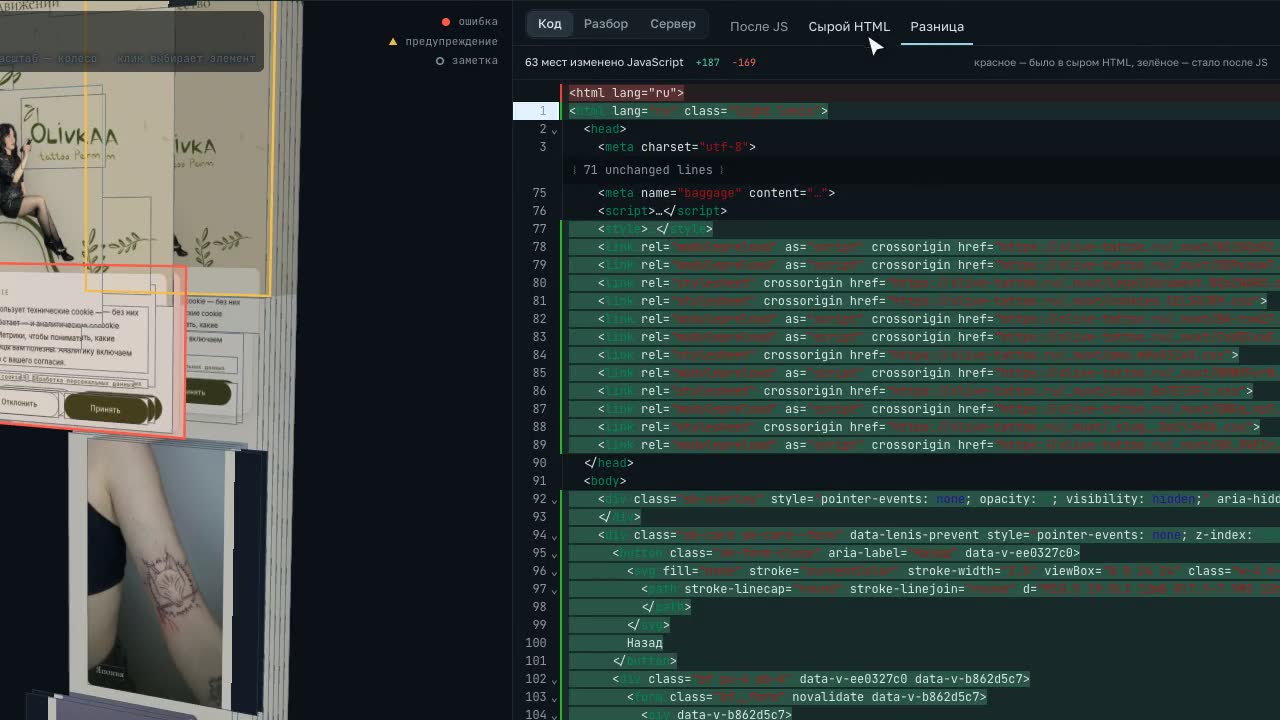
HTML sin procesar ⇄ tras JavaScriptgrabación · ×1

Sin procesar vs renderizado

Lo que ve ChatGPT frente a lo que ve Google

El HTML sin procesar es lo que leen GPTBot, ClaudeBot y PerplexityBot. El HTML renderizado es lo que indexa Googlebot. La pestaña de diferencias los pone lado a lado, línea por línea.

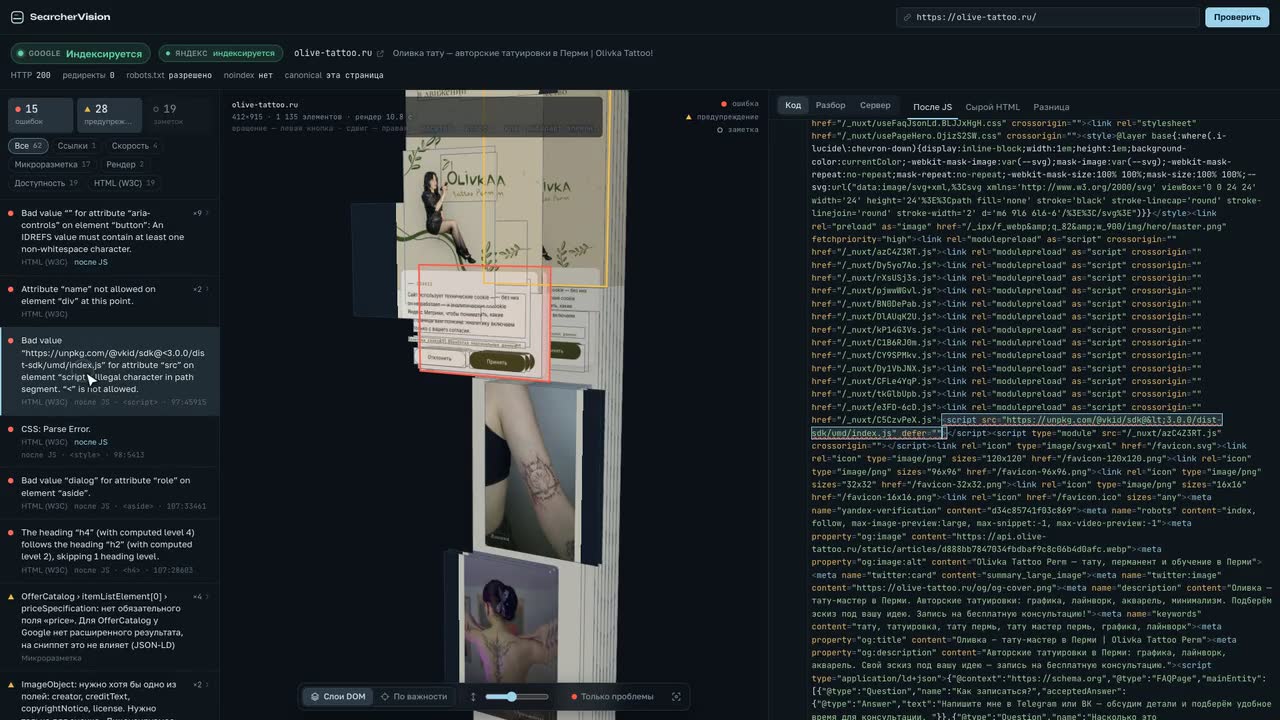
olive-tattoo.ru · 1135 elementos · renderizado 10,8 sgrabación · ×1,15

Informe

Un informe con cada problema de la página

Pasa el cursor por un problema de la lista y el elemento se ilumina en el corte 3D. Elige uno y el código fuente se abre en la línea exacta.

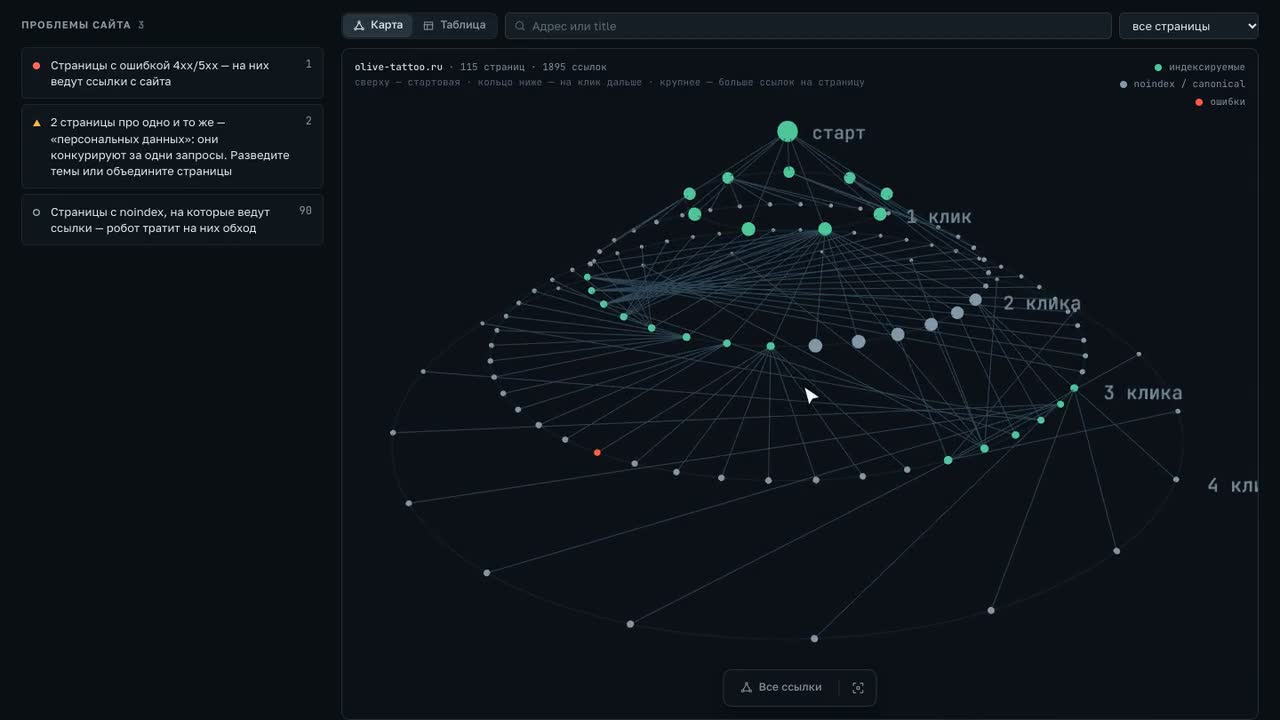
115 páginas en 10 s · sitemap: 24 URLgrabación · ×1,3

Rastreo del sitio

El rastreo del sitio en 3D

En anchura desde la página de inicio, como Googlebot. Las páginas se ordenan en anillos según la profundidad de clics, el color indica si son indexables y un problema del sitio ilumina sus páginas.

HTML sin procesartras JavaScriptGooglebot · rastreadores de IA

Lo que ven los rastreadores y tú no

La página se ve bien en el navegador, pero los rastreadores reciben otra cosa. Cuatro casos que SearcherVision encuentra y señala en el código.

  1. HTML sin procesar14 líneas

    <body>
      <div id="app"></div>
      <script src="/app.js"></script>
    </body>

    tras JavaScript+318 líneas

    <h1>Sofás y sillones</h1>
    <p>Entrega en 2 días…</p>

    ▲ el texto principal aparece solo tras JavaScript

    Contenido que solo existe tras JavaScript

    Googlebot lo renderiza. GPTBot, ClaudeBot y PerplexityBot nunca lo hacen: para ellos, ese texto no existe.

  2. JSON-LD · FAQPage1 de 4 preguntas

    {
      "@type": "Question",
      "name": "¿Cuánto cuesta el envío?",
      "acceptedAnswer": {
        "text": "Gratis en pedidos de más de US$300"
      }
    }

    ▲ la respuesta no está en el texto de la página

    Marcado FAQ sin las respuestas en la página

    Google exige que el contenido marcado sea visible. Comparamos cada respuesta con el texto de la página.

  3. <head>línea 12

    <meta name="yandex" content="noindex">
    Googlebot
    ● indexable
    YandexBot
    ● no indexable

    noindex solo para un buscador

    Una cabecera o una metaetiqueta que oculta la página a un buscador y no al otro.

  4. tras JavaScript<nav>

    <nav>
      <a href="/catalog/chairs">Sillones</a>
      <a href="/catalog/sofas">Sofás</a>
    </nav>

    ▲ este enlace no está en el HTML sin procesar

    Enlaces que aparecen solo tras JavaScript

    Los rastreadores que no renderizan nunca los seguirán.

GooglebotGPTBotClaudeBotPerplexityBot

Google y los rastreadores de IA, lado a lado

Googlebot ejecuta JavaScript antes de indexar. Los rastreadores de IA —los de ChatGPT, Claude y Perplexity— solo leen el HTML sin procesar. SearcherVision muestra las dos versiones de tu página y la diferencia exacta entre ellas.

Googlebot Smartphone

Googlebot/2.1 · renderiza en Chromium

JavaScript
se ejecuta
Lee
HTML renderizado
Texto del catálogo
presente

●Ve la página completa

Rastreadores de IA

GPTBot · ClaudeBot · PerplexityBot

JavaScript
no se ejecuta
Lee
solo HTML sin procesar
Texto del catálogo
falta

●Ve un catálogo vacío

  • HTML sin procesar frente a renderizado, línea por línea

    Mira exactamente qué existe solo tras JavaScript: la parte que los asistentes de IA nunca leen.

  • Reglas de robots.txt para cada rastreador

    Quién puede entrar: GPTBot, ClaudeBot, PerplexityBot, Google-Extended, y si el servidor de verdad los deja pasar.

  • También YandexBot

    Para sitios en Rusia y la CEI: un veredicto aparte de Yandex.

Por qué los rastreadores de IA no ejecutan JavaScript (en inglés) →

Qué analizamosreglas deterministas

Qué analizamos en cada página

Cada comprobación es determinista. Cada problema apunta a una línea y una columna del código fuente y al elemento en el corte 3D.

Indexación

  • robots.txt, redirecciones, noindex y canonical en las metaetiquetas y en las cabeceras.

Método: User agents de Googlebot Smartphone y YandexBot

Renderizado

  • Chromium móvil a 412×915, como Googlebot Smartphone.
  • Los recursos bloqueados en robots.txt no se cargan; la página no se desplaza.

Método: Chromium · Playwright

Código y W3C

  • Errores de Nu Html Checker vinculados al elemento exacto, en el código y en 3D.

Método: Nu Html Checker, el motor de validator.w3.org

Datos estructurados

  • JSON-LD y Microdata según las reglas de Google, en bloques legibles: FAQ, precios, organización.

Método: Vocabulario de schema.org · reglas de resultados enriquecidos de Google

Velocidad

  • TTFB, FCP, LCP, CLS y TBT, más PageSpeed Insights y datos reales de Chrome cuando los hay.

Método: Chromium · PageSpeed Insights

Semántica

  • De qué trata la página para un rastreador: el tema por zonas — title, h1, URL, JSON-LD, encabezados.

Método: Reglas deterministas: cada problema tiene su lugar en el código

rastreo en anchurahasta 1000 páginas

Rastrea todo el sitio y míralo en 3D

En anchura desde la página de inicio, como Googlebot: hasta 1000 páginas con HTML sin procesar o 300 con renderizado. Páginas rotas y quién enlaza a ellas, redirecciones, títulos duplicados, páginas huérfanas, huecos en el sitemap y canibalización de palabras clave, en un mapa 3D de profundidad de clics.

Probar gratis

example.com · 134 páginas
rastreo del HTML sin procesar · 41 s

  • indexable · 93
  • no indexable · 16
  • ▲redirección · 12
  • ●error 4xx/5xx · 7
  • ○huérfana · 6

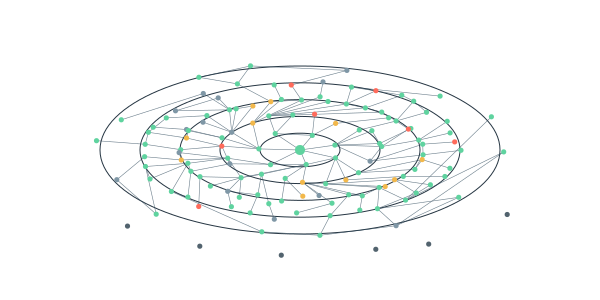
anillos: clics desde el inicio

Páginas en anillos de profundidad de clics; el color indica si la página es indexable; las líneas son enlaces. La app también lista todas las páginas en una tabla.

MCPStreamable HTTP

Tu agente de código corrige los errores de SEO

Conecta SearcherVision a Claude Code, Cursor o cualquier cliente MCP. El agente analiza una página, recibe cada problema con su posición en el código y lo corrige.

El servidor MCP responde en inglés; tu agente te habla en tu idioma.

Herramientas del servidor · 7
analyze_page
analiza una página: veredictos de Google y Yandex, los problemas principales con su lugar en el HTML y un enlace al informe 3D
get_report
todos los problemas de un informe, filtrados por categoría y gravedad
get_html
el código alrededor de una línea y una columna, para encontrarlo y corregirlo
get_structured_data
los datos estructurados encontrados en la página
crawl_site
rastrea un sitio, hasta 1000 páginas: páginas rotas, duplicados, huérfanas, canibalización, sitemap, profundidad
get_crawl
los problemas del rastreo con cada URL afectada
list_recent
los análisis recientes

Dirección del servidor: https://api.searchervision.com/mcp

Claude Code · configuración

claude mcp add --transport http searcher-vision https://api.searchervision.com/mcp

Revisa la página de inicio y corrige los errores de marcado

searcher-vision · analyze_page(https://example.com/)

Google: indexable · Yandex: indexable
Problems: 3 errors, 5 warnings, 12 notes

Errors:
- [HTML (W3C)] Bad value "dialog" for attribute "role"
  after JS 107:33498 <aside> cid=412
- [Structured data] Product › offers: "price" is missing
  raw HTML 41:5

get_html(cid=412) → editando components/Sidebar.vue

Precios

Gratis durante la beta. Pro está en camino.

Usa SearcherVision gratis mientras esté en beta. Pro y Agency están en desarrollo: únete a la lista para el acceso anticipado.

  • Gratis

    US$0

    Funciona hoy, sin registro.

    • 40 análisis de página por hora
    • 6 rastreos de sitio al día
    • MCP para tu agente
    Probar gratis
  • Pro

    en desarrollo

    US$19/mes

    Para quienes revisan sitios todos los días.

    • Límites más altos
    • Integración con Search Console
    • Análisis para rastreadores de IA
    • Informes listos para clientes
    Acceso anticipado
  • Agency

    desde US$99/mes

    Para equipos que gestionan sitios de clientes.

    • Puestos para el equipo
    • Informes con tu marca
    • API
    Hablemos

Los precios son una hipótesis: únete a la lista y cuéntanos por qué pagarías.

FAQPageel marcado coincide con el texto

Preguntas frecuentes

Las respuestas de esta página y las de sus datos estructurados coinciden palabra por palabra: justo lo que SearcherVision comprueba en el marcado FAQ.

¿En qué se diferencia de Google Search Console?

Search Console solo muestra tus propios sitios verificados y solo Google. SearcherVision analiza cualquier URL, muestra Google y los rastreadores de IA lado a lado y señala el elemento exacto en el código.

¿En qué se diferencia de una auditoría SEO clásica?

Una auditoría SEO suele ser una lista de recomendaciones. Aquí cada problema tiene su lugar exacto: la línea y la columna en el código y el elemento en el corte 3D, con el HTML sin procesar y el renderizado lado a lado.

¿Necesito acceso al sitio?

No. Sirve cualquier URL pública.

¿Por qué los resultados pueden diferir de los de Google?

Emulamos los rastreadores desde nuestro servidor. Las reglas geográficas y la protección contra bots ven nuestro servidor, no a Google. La integración con Search Console (llegará en Pro) añadirá los datos del propio Google.

¿De verdad los rastreadores de IA no ejecutan JavaScript?

GPTBot, ClaudeBot y PerplexityBot descargan el HTML sin procesar y no ejecutan JavaScript, según el análisis de su tráfico que publicó Vercel. Google-Extended es la excepción: usa el renderizado de Google.

¿Cuáles son los límites?

40 análisis por hora y 6 rastreos al día por IP durante la beta.

¿La app está en español?

Sí: la interfaz, las descripciones de los problemas y los veredictos. El selector de idioma está en el encabezado. El servidor MCP responde en inglés.